Готовая выгрузка
Не нужно повторять длительное сканирование. Можно использовать результат Screaming Frog или другого краулера.
Готовые выгрузки Screaming Frog, Netpeak Spider или другого краулера превращаются в понятный аудит с масштабом ошибок, приоритетами и полными списками URL.
Загрузите выгрузки краулера — SEOскоп распознает типы файлов, объединит листы, проверит домен, отделит URL от внутренних ссылок и подготовит аудит с приоритетами, доказательствами и полными таблицами.
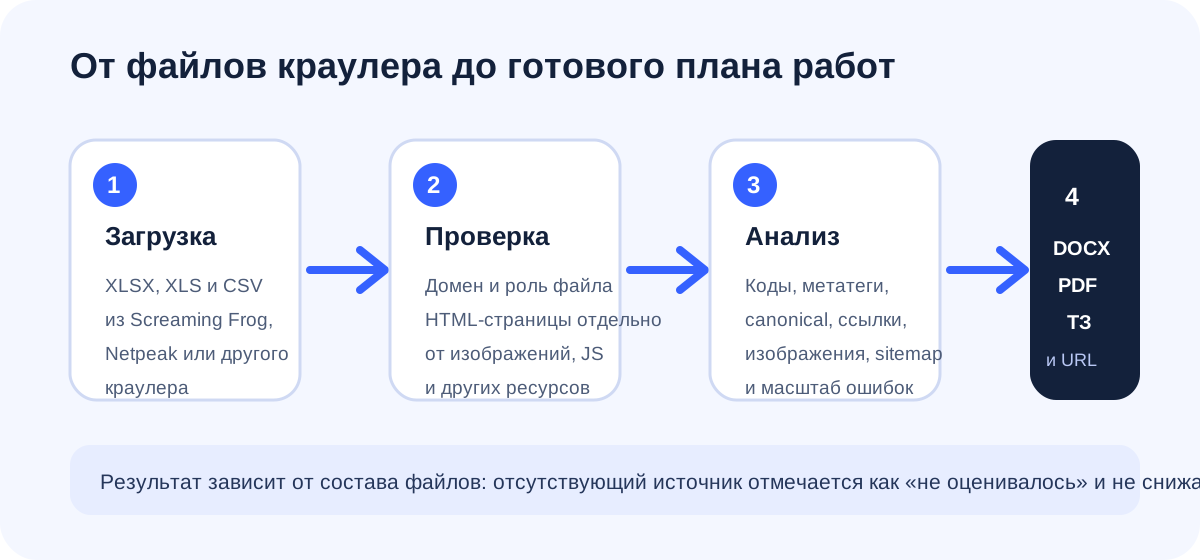
Этот сценарий подходит для больших сайтов, проектов за авторизацией, тестовых контуров и случаев, когда SEO-специалист уже настроил обход: выбрал User-Agent, JavaScript-рендеринг, глубину, параметры, правила robots.txt и нужные поддомены.
Не нужно повторять длительное сканирование. Можно использовать результат Screaming Frog или другого краулера.
Файлы позволяют передать десятки тысяч URL и отдельные массивы ссылок, метатегов, изображений и кодов ответа.
Сохраняется выбранная область: JavaScript, cookies, авторизация, include/exclude, лимиты и пользовательский агент.
| Выгрузка | Что проверяет SEOскоп | Типичные выводы |
|---|---|---|
| Internal / URL | Область сайта, типы страниц, глубина и indexability | Архитектура, технические URL, охват выборки |
| Response Codes | 200, 3xx, 4xx, 5xx и страницы-источники | Битые ссылки, редиректы, серверные ошибки |
| Titles / Description / H1 | Пропуски, дубли, длина и шаблоны | Массовые дефекты CMS и слабые сниппеты |
| Canonical / Pagination | Канонические версии, параметры и пагинация | Дубли, crawl-trap и конфликт сигналов |
| Images / JavaScript | Вес, размеры, alt и ресурсы | Тяжелые изображения, большие JS-бандлы |
| Links | Источник, цель, анкор, код ответа | 404 со страницами-источниками, глубина и перелинковка |
Количество строк не равно количеству страниц: файл внутренних ссылок может содержать миллионы строк для нескольких тысяч URL. Поэтому сервис отдельно считает уникальные страницы, ссылки, страницы-источники и записи sitemap.
Если какой-то источник не загружен, направление помечается как «не оценивалось» и не снижает балл. Это отличает отсутствие данных от реальной ошибки сайта.
Сравнить все варианты SEO-аудита · Запустить собственный краулер
Если обход сайта уже выполнен, его результаты можно использовать для аудита по файлам. На странице сервиса заявлены XLSX и CSV; состав распознанных данных проверьте после загрузки до запуска анализа.
Сохраните исходную выгрузку, названия столбцов и дату обхода. Выгружайте данные одного понятного проекта: смешение доменов и разных запусков затрудняет выводы о состоянии сайта. Не заменяйте пустые значения нулями и не удаляйте строки только потому, что в них обнаружена ошибка.
Ниже — виды сведений, которые полезно проверить в выгрузке. Это описание данных, а не шаблон обязательных колонок импортера.
На узком экране таблицу можно прокрутить вбок. С клавиатуры используйте Tab и стрелки.
| Вид сведений | Что проверить перед загрузкой |
|---|---|
| Страницы и ответы | Адреса URL, тип ресурса, HTTP-статус, дата обхода |
| Метаданные | Связь Title, Description и H1 с конкретным URL |
| Canonical | Адрес страницы и указанная каноническая версия |
| Ссылки | Страница-источник, целевой адрес и доступные свойства ссылки |
Строка таблицы не всегда означает отдельную страницу. Один адрес может встречаться во многих ссылках; изображения, скрипты и HTML относятся к разным типам ресурсов. Поэтому число строк, количество уникальных URL и число проверенных HTML-страниц учитываются отдельно.
Учебный пример: десять ссылок ведут на одну услугу. Это десять связей и один целевой URL. Долю проверенного сайта можно назвать только при известном составе сравниваемого корпуса; одна неполная выгрузка такого основания не даёт.
При пустом файле проверьте, экспортированы ли строки. При неверном распознавании столбцов вернитесь к исходному формату краулера. Повреждённый файл выгрузите заново. Если передана только часть данных, обозначьте её границы и добавьте недостающие выгрузки до анализа, когда это позволяет текущий режим.
XLSX, XLS и CSV из Screaming Frog, Netpeak Spider и других краулеров. Лучше передавать URL, Internal, Response Codes, Title, Description, H1, Canonical, Images, Pagination и Links.
Нет, но полнота выводов зависит от состава данных. SEOскоп показывает, какие направления подтверждены, а какие не оценивались.
Да. Файлы можно добавлять несколькими пакетами до запуска анализа; ранее выбранные документы не удаляются.
Файлы удобны для очень больших, закрытых или специально настроенных сайтов. Автокраулер быстрее запускается и дополнительно сохраняет готовые выгрузки для повторного анализа.
Да, если имеющаяся выгрузка достаточно свежая и содержит нужные сведения. Изменения после её даты в ней не отражены.
В таблице могут повторяться URL и перечисляться отдельные ссылки или ресурсы.
Ограничить выводы её охватом либо подготовить дополнительные данные.
По вашему запросу ответы не найдены. Попробуйте другое слово.
Разделите CSV или табличный XLSX на части по максимальному размеру и целым строкам. Сохраните все части одной выгрузки вместе: разделение файла не расширяет фактический охват аудита и не заменяет анализ всего набора.
Отличаются источник данных, тип сайта и этап работы. Выберите подходящее направление.
Первый шаг — бесплатно
Оставьте сайт на бесплатный SEO-аудит. Посмотрим, что мешает его развитию, и подскажем, на чём стоит сосредоточиться в первую очередь.
Это заявка на первичный разбор специалистом. Полный аудит, сроки и дальнейшие работы обсуждаются отдельно. Оплата и регистрация для заявки не нужны.
Выберите режим в кабинете и проверьте его условия. Автоматический обход, аудит по файлам и первичный разбор специалистом — разные сценарии. Доступность приёма заявки указана в форме.