Сначала порядок в списке
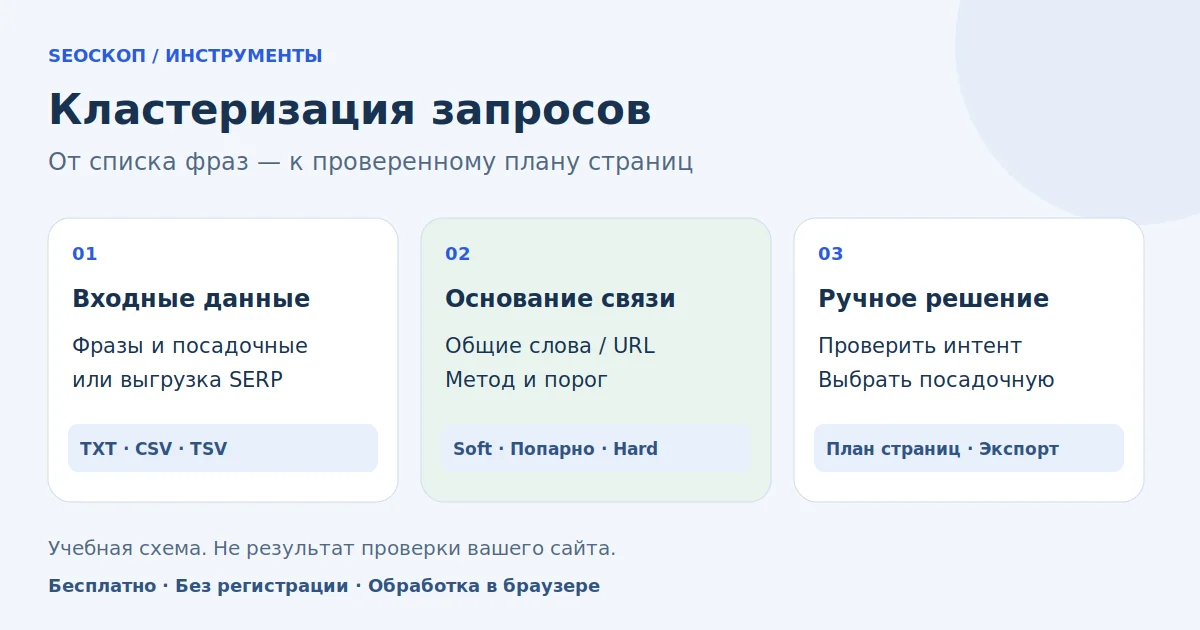
Загрузите TXT, CSV или TSV. Сохраните частотность, интент, сегмент и текущую посадочную рядом с запросом. Сервис покажет повторы и сохранит исходные варианты в JSON.
Разберите семантическое ядро, проверьте основания группировки и подготовьте план посадочных. Начните со списка фраз или собственной выгрузки выдачи.
Выберите режим. По словам — предварительные группы; по выдаче — связь на основе загруженных URL. Без регистрации.
Выберите режим и добавьте данные. Учебный список не заменяет заполненное поле.
Содержимое списка обрабатывается локально в браузере. Инструмент не посещает импортированные URL и не подключается к поисковым кабинетам. Рабочий результат не сохраняется между перезагрузками — скачайте его перед закрытием страницы.
Фоновый расчёт ограничен 20 секундами. Если Worker недоступен, лимит — 300 непустых строк и 100 КиБ. Некорректные и слишком большие файлы отклоняются с объяснением, без частичного отчёта.
Загрузите TXT, CSV или TSV. Сохраните частотность, интент, сегмент и текущую посадочную рядом с запросом. Сервис покажет повторы и сохранит исходные варианты в JSON.
Для лексических групп доступны общие слова. Для импортированной выдачи — общие URL, маркер и полнота выбранного ТОПа. Номера моделей и C#/C++ не теряются при нормализации.
Переключитесь с запросов на план: найдите группы без URL и несколько посадочных в одной группе. Выгрузите рабочий список, чтобы проверить страницу или подготовить отдельное ТЗ.
| Режим | Что сравнивается | Когда полезен |
|---|---|---|
| По словам | Пересечение значимых слов. Порог задаёт минимальную долю общих токенов. | Быстро разобрать черновое ядро и подготовить список для проверки интента. |
| Импортированная выдача | Уникальные URL из одного среза: поисковик, регион, устройство, язык, дата. | Проверить, какие запросы имеют общие документы в переданном ТОПе. |
| План посадочных | Группы, запросы и URL, которые вы уже указали в файле. | Распределить редакторские задачи, не создавая отдельную страницу под каждый вариант фразы. |
Каждый запрос связан с неизменным маркером группы. Между другими участниками порог может не выполняться.
Каждая пара достигает выбранного порога. Общие URL в разных парах могут отличаться.
Минимум N URL входит в общее пересечение всех запросов. Доступен только для импортированной выдачи.
Задача пользователя и тип документов совпадают, а существующий URL способен полноценно раскрыть группу. Расширьте содержание и внутренние ссылки.
Меняется интент, объект, регион или коммерческое предложение. Проверьте, нужна ли самостоятельная посадочная с уникальной пользой.
В группе уже несколько URL. Сопоставьте назначение, показы, позиции и конверсии в проверке каннибализации. Не объединяйте страницы автоматически.
Да. Обработка списка и загруженной выдачи выполняется в браузере без регистрации. Лимит — 5000 уникальных запросов, 50 000 строк и 8 МиБ UTF-8. Плотный список может превысить бюджет сравнений: тогда разделите его на сегменты.
Нет. В режиме SERP нужно передать собственную таблицу query, url, rank и единый поисковый срез. В режиме по словам выдача вообще не используется. Источник и дата вашего файла определяют актуальность результата.
В Soft запросы сравниваются с постоянным маркером. В попарном режиме порог выполняется для каждой пары. В Hard у всех запросов группы есть общий набор URL заданного размера. Hard доступен только для импортированной выдачи.
Регистр, лишние пробелы и Unicode-нормализация сводят точные повторы; варианты сохраняются в JSON. Перестановка слов остаётся отдельной фразой, но может войти в ту же группу. Решение о посадочной принимается по интенту, а не по числу формулировок.
Да, передайте её столбцом volume. Пустое значение означает отсутствие данных. Если у дубля разные значения, сохраняется диапазон; сумма известных максимумов не равна уникальному спросу. Сервис не собирает частотность автоматически.
Представление «План посадочных» показывает существующие URL, группы без назначения и несколько посадочных в одной группе. Это рабочий список для проверки. Он не создаёт страницы и не назначает URL автоматически.
Проверьте выбранный порог, интенты, номера моделей, сегменты и полноту выдачи. Лексический режим не выполняет морфологический анализ: для словоформ можно задать небольшой проверенный словарь. Не ослабляйте порог только ради уменьшения числа групп.
По вашему запросу ответы не найдены. Попробуйте другое слово.